1.物体识别介绍
HUSKYLENS 2的物体识别功能可识别80种固定类别的物体,检测时可自动框出目标物体并显示名称及置信度(如“剪刀 19%”)。
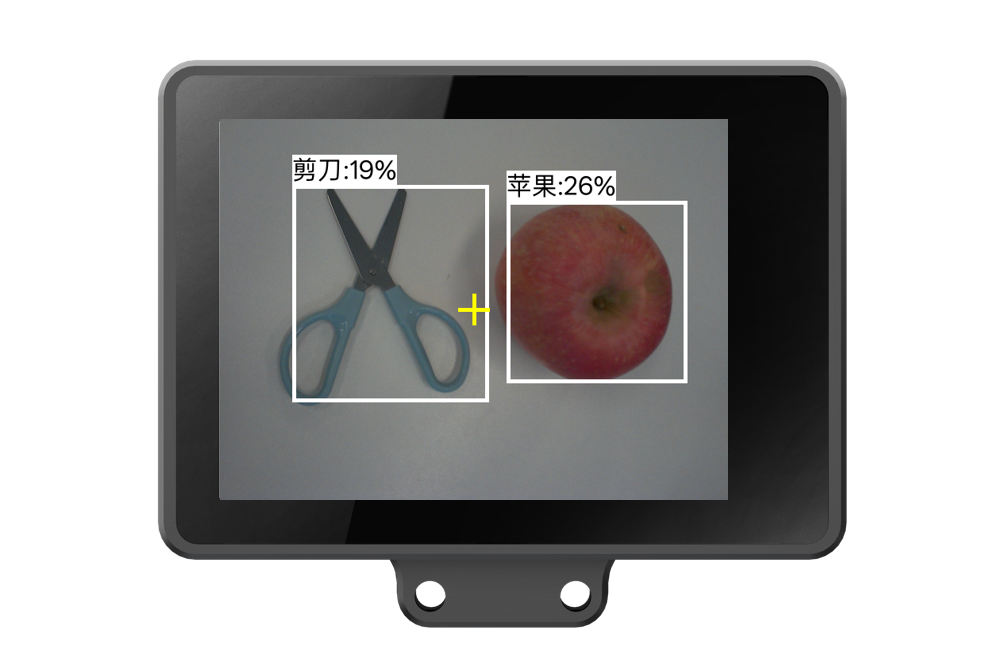
此目标检测模型基于MS COCO80数据集训练,识别时可能会因为实际物体和该模型学习过的数据有一定差异,导致置信度较低。(置信度是模型在当前输入条件下对预测结果的“确定程度”指标。表示模型认为目标属于某一类别的相对可信度)
本功能是生活中常见物体的通用识别,无法分辨同类物体间的不同,例如:只能识别出“猫”,但不能识别出猫的品种。如需分辨同类物体,可使用"自学习分类"功能或自训练目标检测模型。
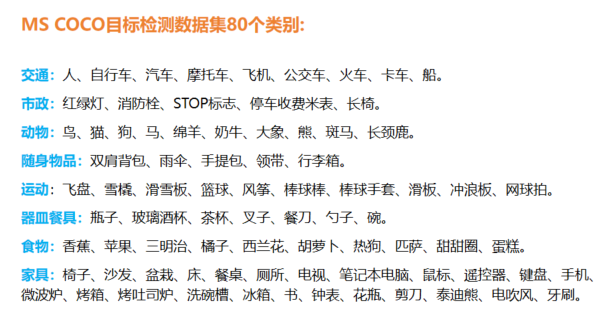
可识别的物体如下:
2.物体识别使用说明
这一部分我们将了解如何使用HUSKYLENS 2的物体识别功能识别出画面中的物体以及学习指定物体。
2.1 选择物体识别功能
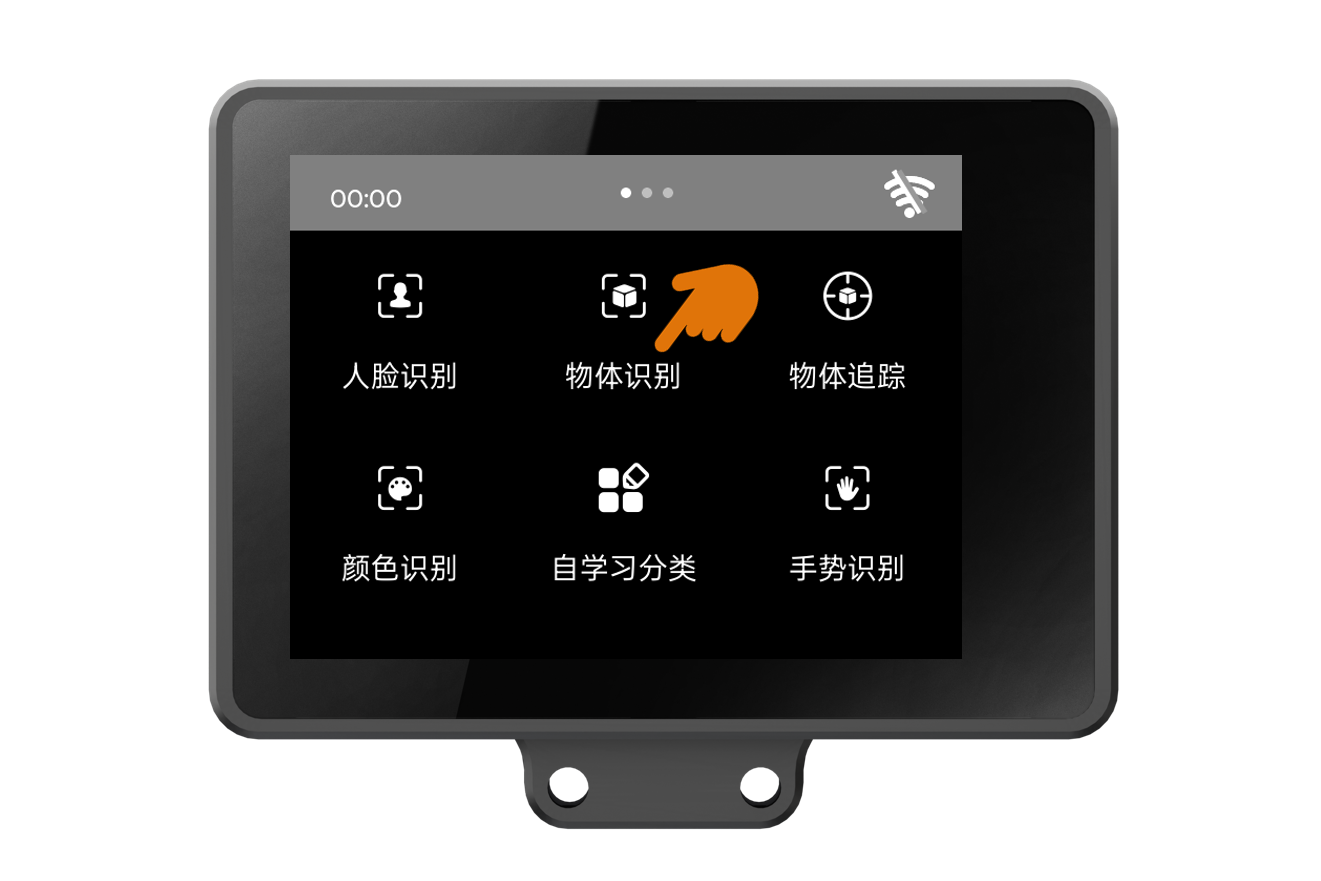
给HUSKYLENS 2供电,启动成功后,找到并点击“物体识别”功能。
2.2 观察物体识别效果
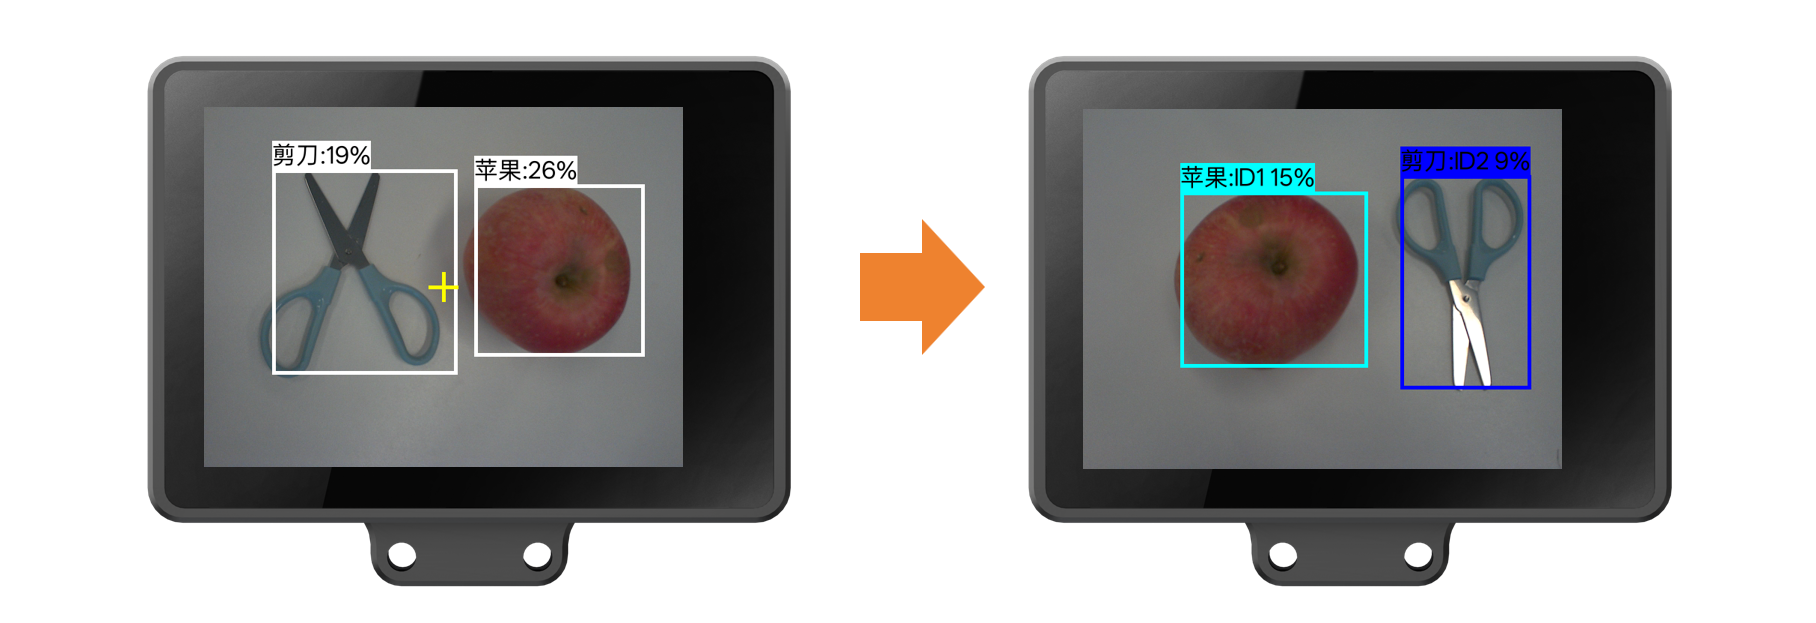
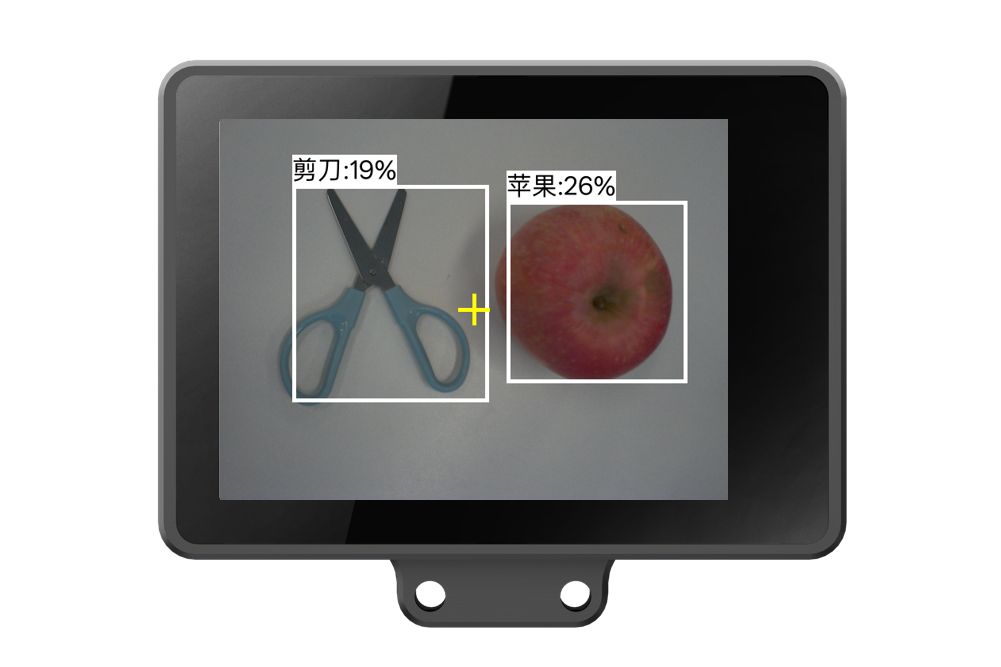
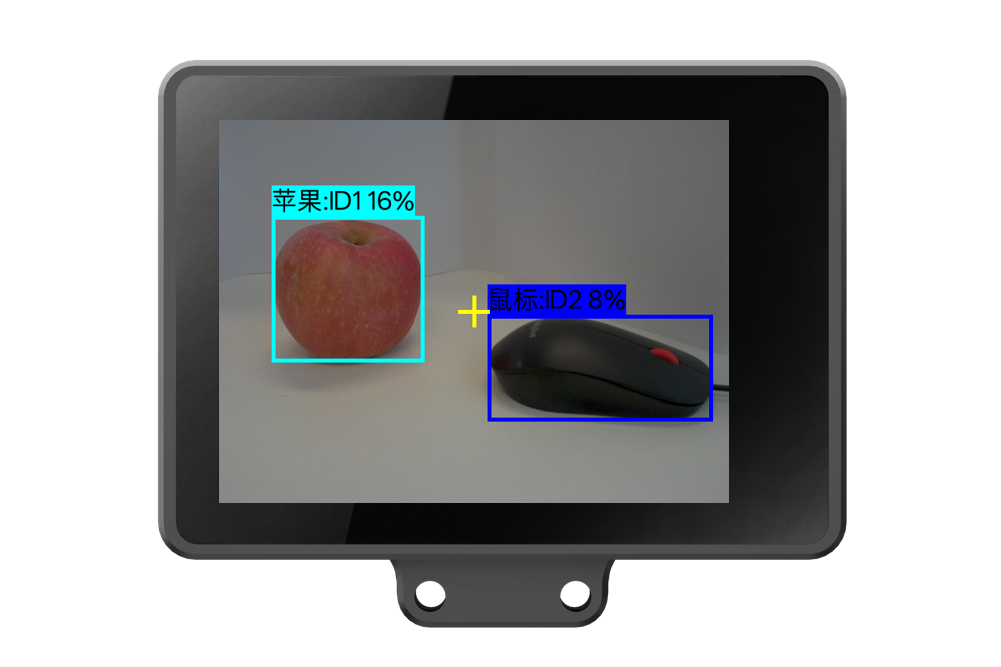
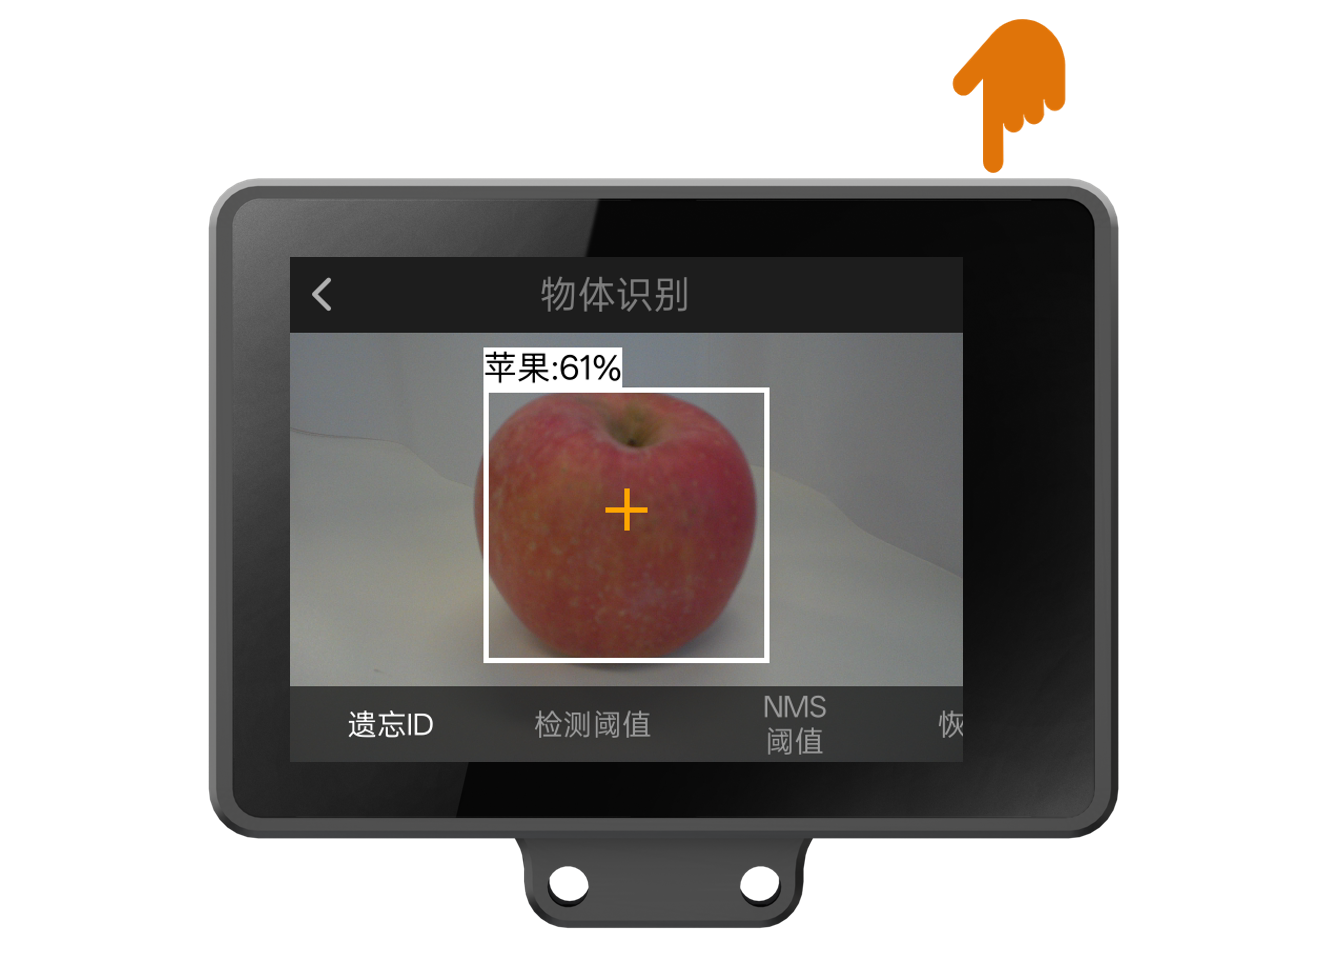
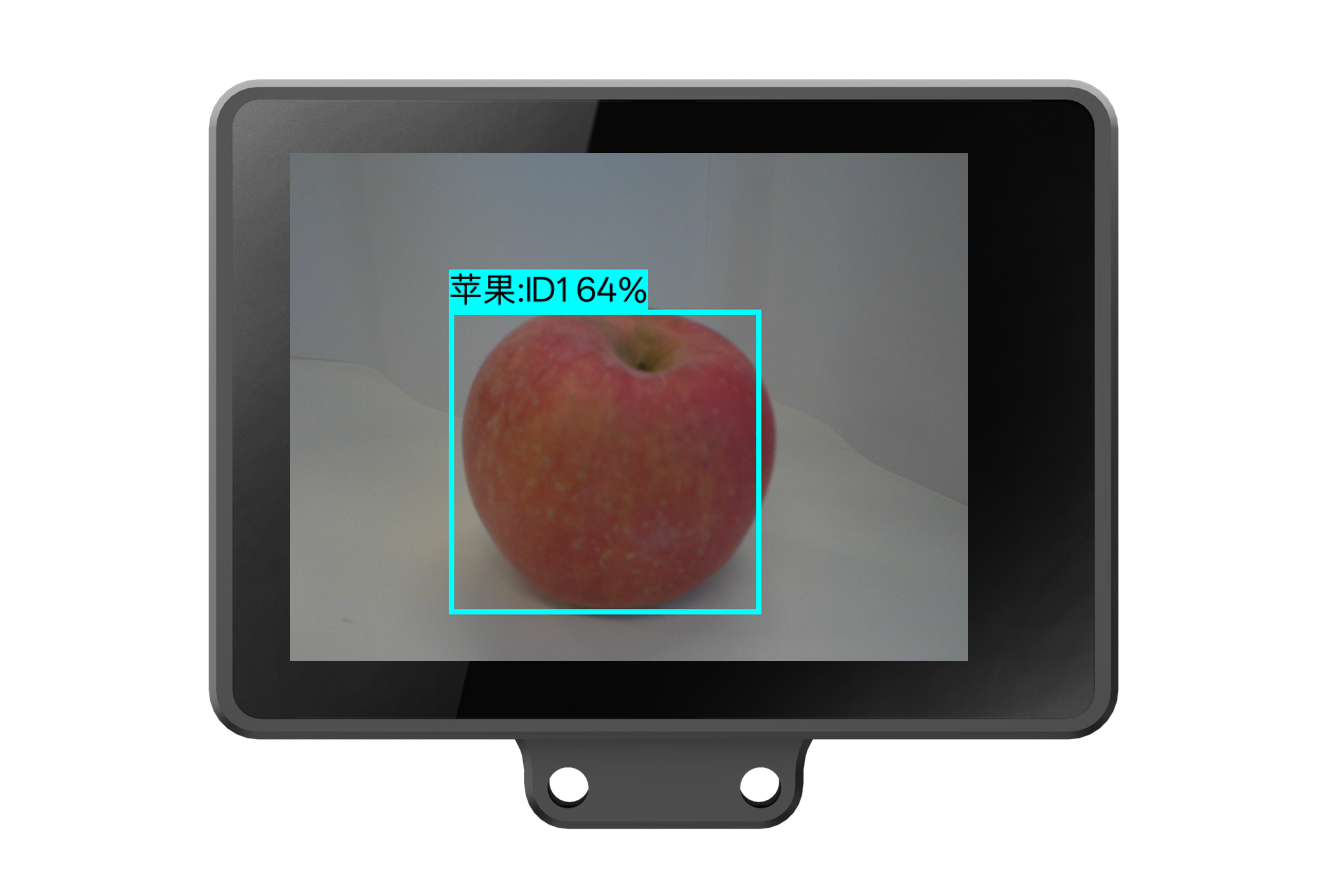
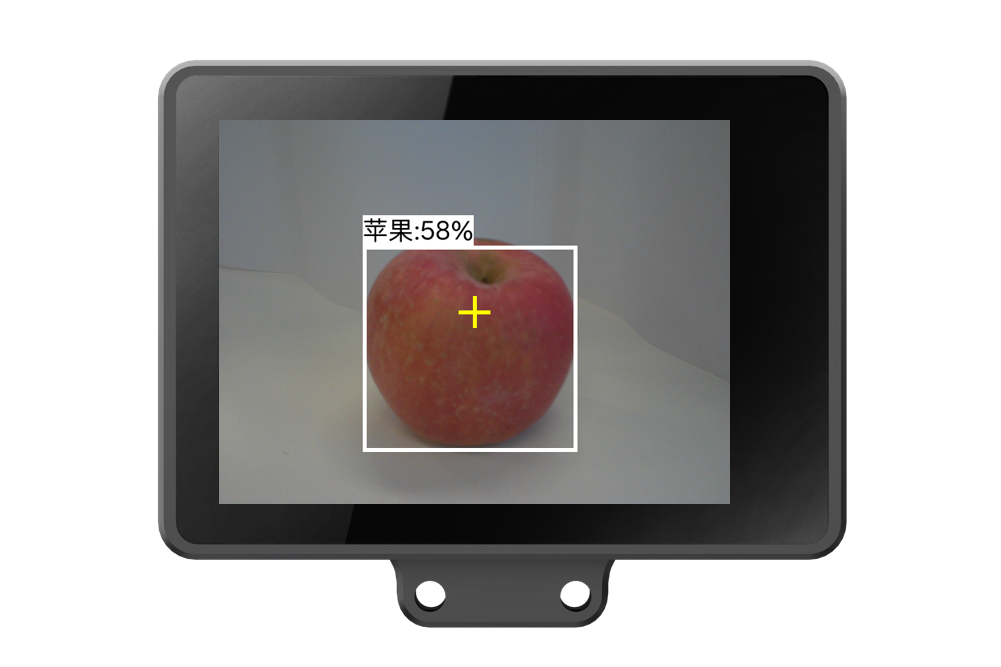
将HUSKYLENS 2“看”向可识别的物体,观察HUSKYLENS 2的屏幕,画面中所有可识别的物体将被白色方框框出,并显示对应物体名称及置信度。在机器学习中,置信度指的是模型对自己预测结果的“确定程度", 比如"苹果 26%",表示在物体识别功能下模型认为当前画面中的该物体有26%的可能性是“苹果”。
2.3 学习物体观察结果
用户可针对80类中的任意物体进行学习,系统会按学习顺序分配唯一ID号,后续可通过ID号在项目程序中执行逻辑判断。
3.物体识别参数设置
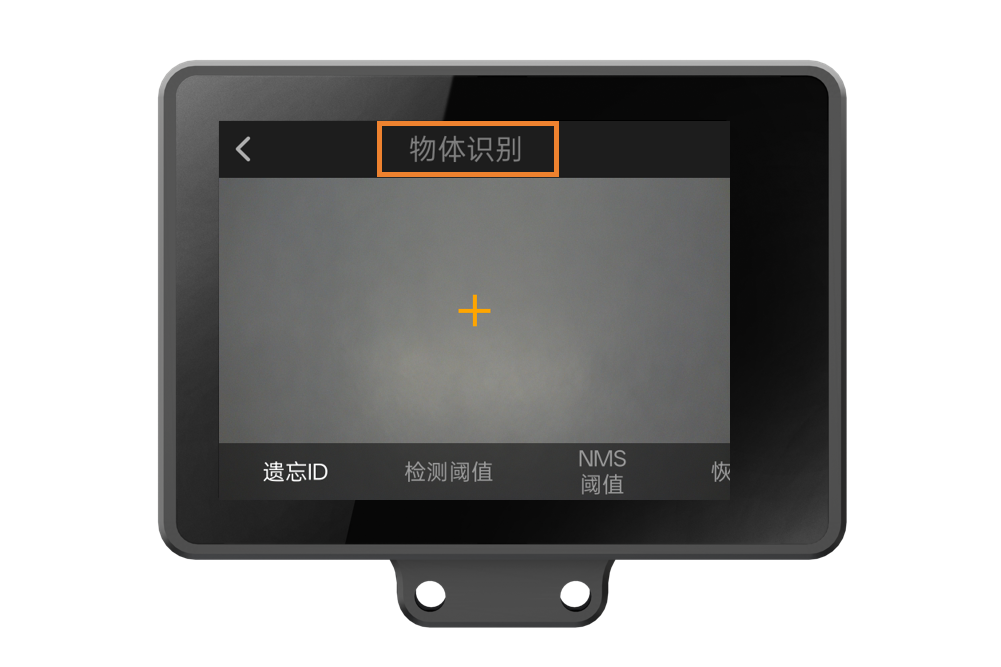
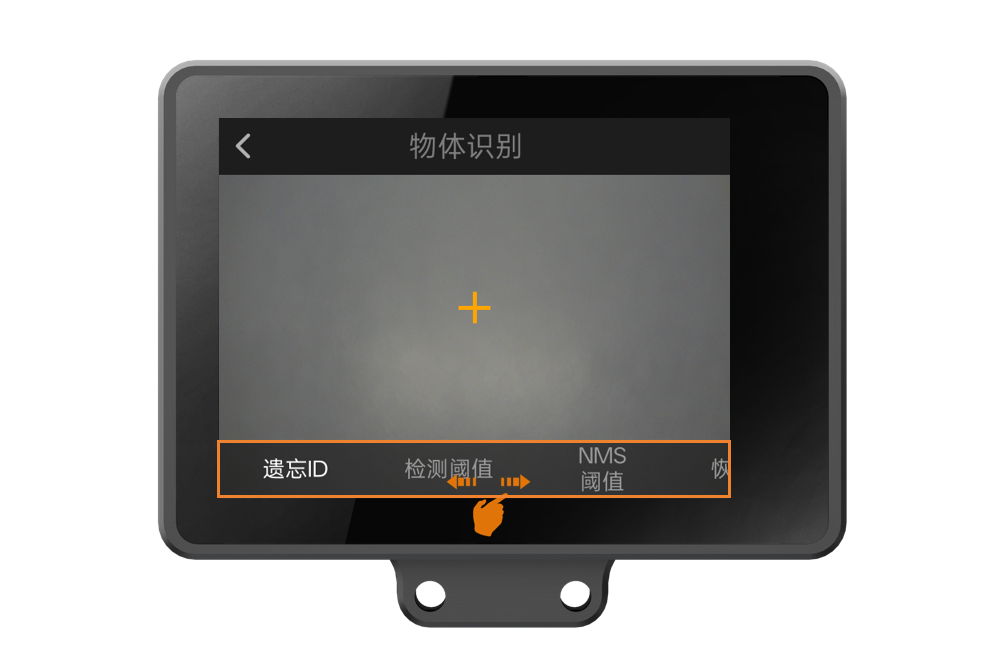
HUSKYLENS 2出厂的默认参数已满足基础功能使用需求,可手动调节各个参数设置个性化的功能。以下参数均基于“物体识别”功能,因此,首先确保已进入“物体识别”功能,如图所示。
.3.1 遗忘ID
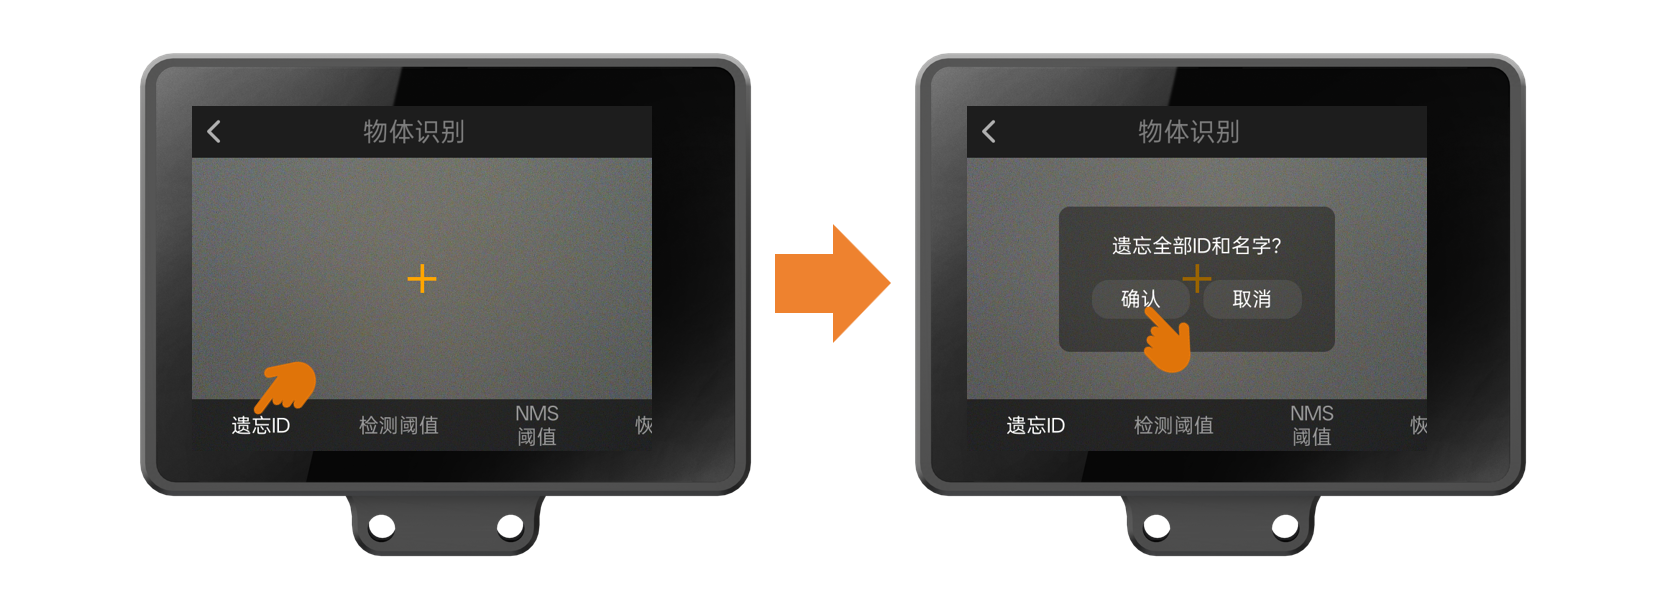
如需遗忘前面学习过的所有物体:第一步,点击屏幕上的“遗忘ID”;第二步,出现弹窗“遗忘全部ID和名字”后,点击“确认”。
3.2 检测阈值
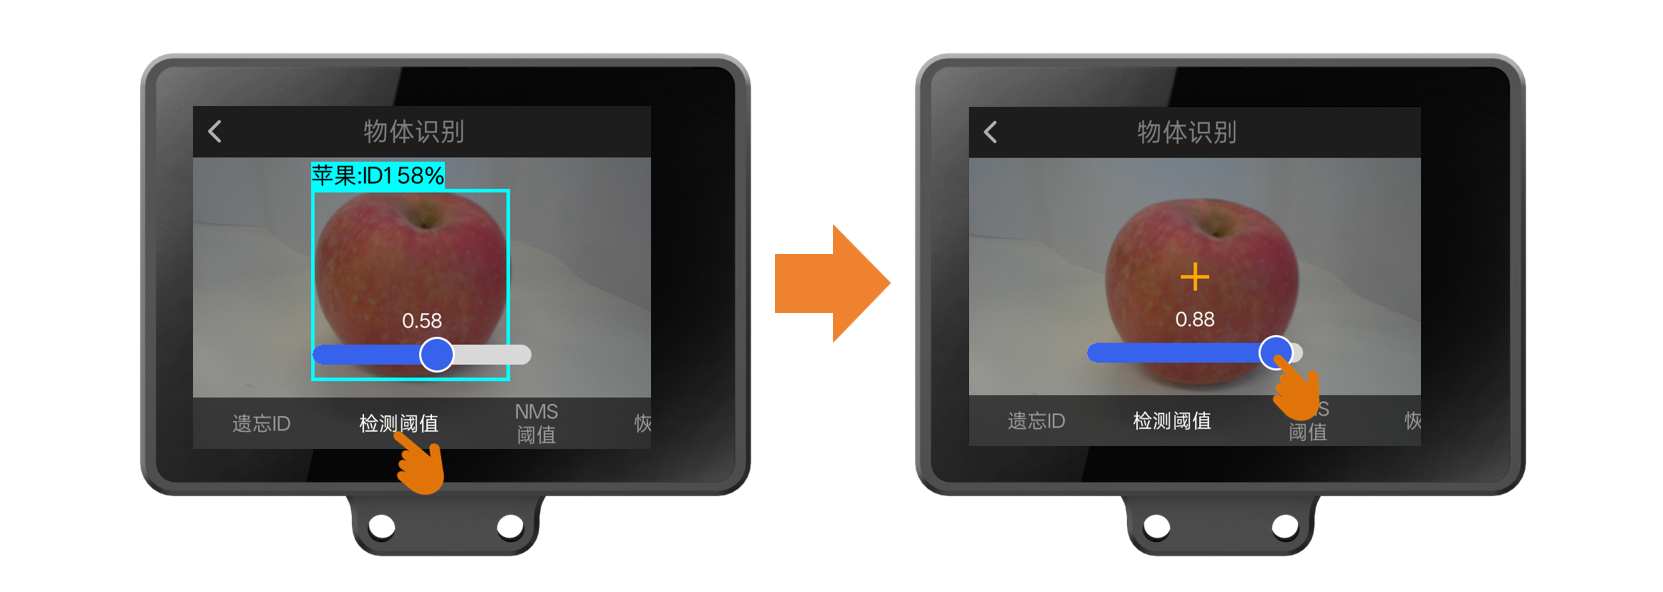
检测阈值控制物体识别的严格程度:阈值越小,识别出该物体所需的置信度分数越低;阈值越大,所需置信度分数越高。
设置步骤:点击“检测阈值”,其上方出现参数调节滑杆,左滑变小,右滑变大,效果如图。
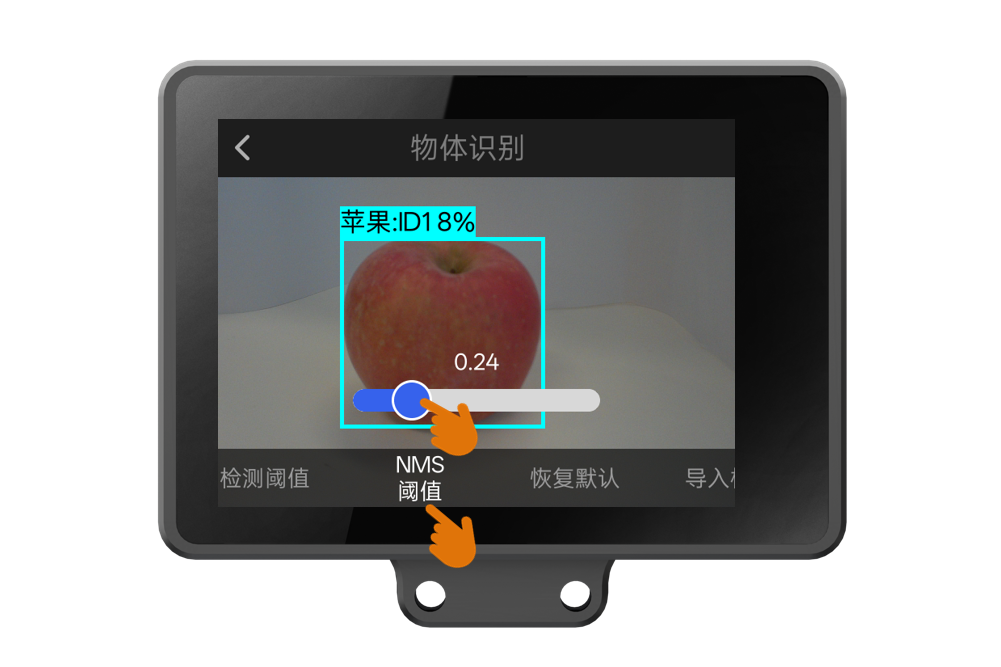
3.3 NMS阈值
NMS阈值(Non-Maximum Suppression)非极大值抑制,是视觉识别中的一个常见参数,用来筛选识别框。在视觉识别任务中,模型往往会在同一个识别目标周围预测出多个相互之间可能有重叠的识别框。如果不进行筛选就可能出现:一个目标物体被多个框同时框出,这些框相互之间有交叉重叠的现象,这时就可以通过调整NMS 阈值来去掉交叉重复的框,只保留最优的一个。
通俗来说,NMS 阈值决定了 两个框重叠多少才算“重复”。举例来讲:如果阈值低(比如 0.3):两个框只要有点重叠,就会认为是重复的,去掉其中一个。如果阈值高(比如 0.7):两个框重叠很多才会被认为是重复的,保留下来的框可能更多。
高阈值适合密集/遮挡场景,能抓住更多物体,但可能出现“一物多框”。低阈值适合清晰单物体场景,确保每物一框,但可能漏掉模糊物体。
在本功能的参数中,设置步骤:点击“NMS阈值”,其上方出现参数调节滑杆,左滑变小,右滑变大。
3.4恢复默认
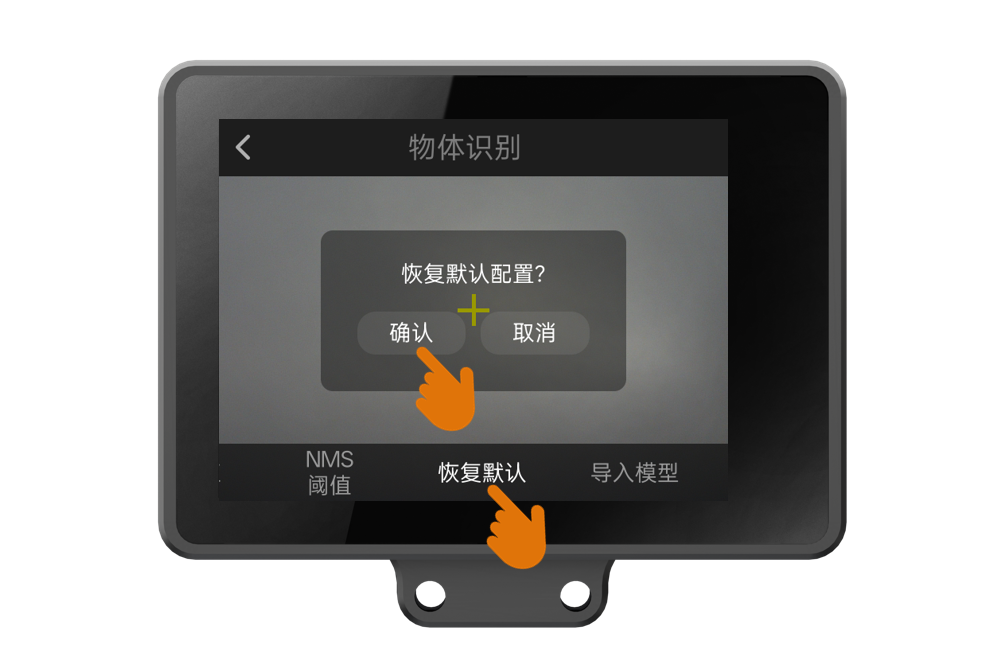
本参数可将所有设置项恢复为默认状态,并遗忘已学习的ID,但不清空导出的模型(关于导出模型请看下文)。
设置步骤:点击“恢复默认”,出现“恢复默认配置”弹窗后,点击“确认”。
3.5导出模型
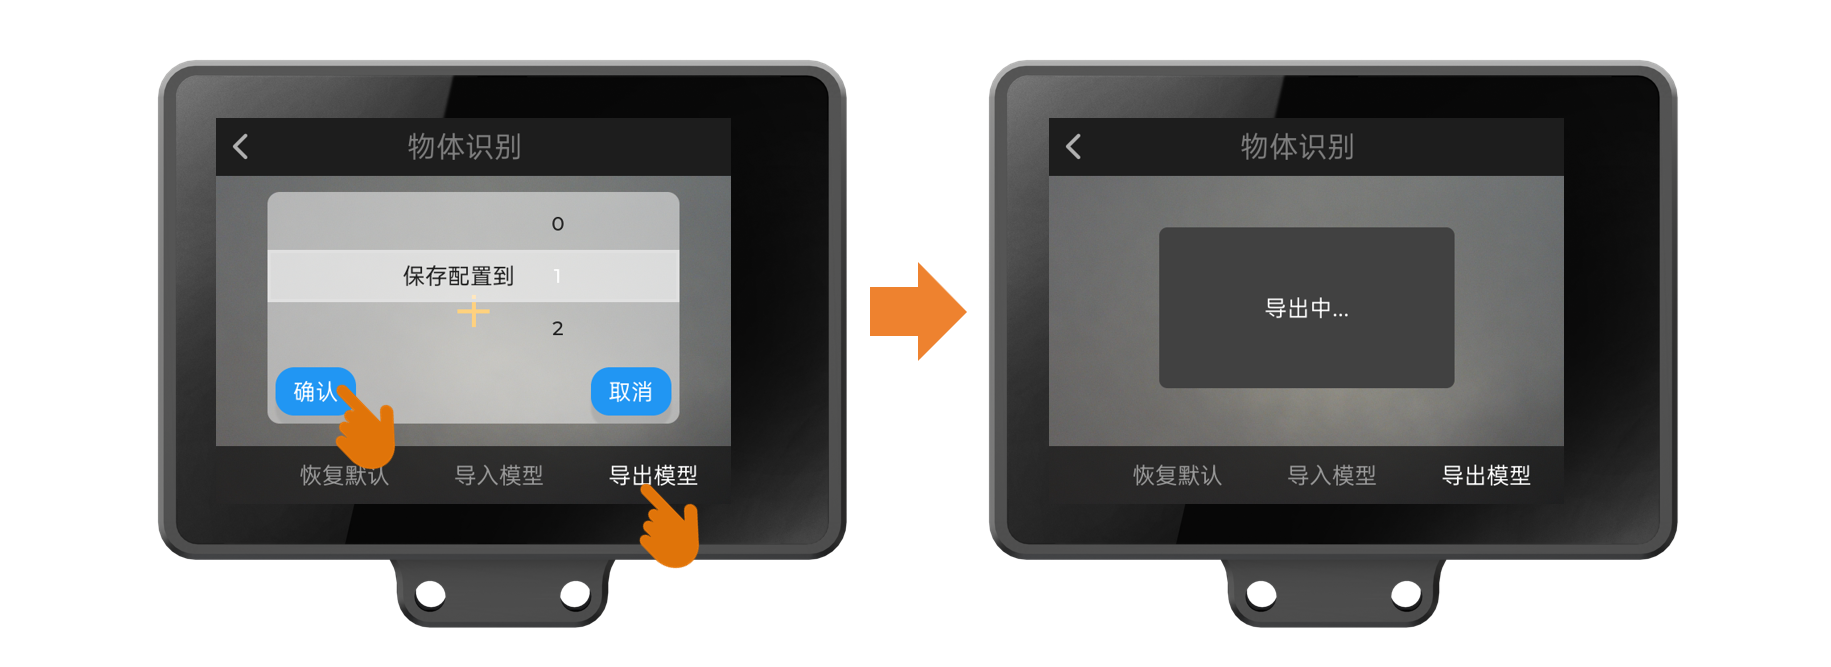
本参数可将当前设置的参数、学习的ID,保存、导出到HUSKYLENS 2本地内存。适用于迁移参数至另一个HUSKYLENS 2等场景。此操作无需插TF卡。
导出步骤:点击“导出模型”,出现左图“保存配置到”弹窗时,上下滑动数字,选择保存为几号模型(共可保存5个模型),随后点击弹窗左下角的“确认”按钮以保存。确认后,自动导出,如右图。
3.6导入模型
本参数可以将HUSKYLENS 2(以下称“二哈A”)导出的模型导入到另一个HUSKYLENS 2(以下称“二哈B”)上,以便二哈B不用重新学习物体也可以识别出二哈A学习过的物体显示ID和名称。
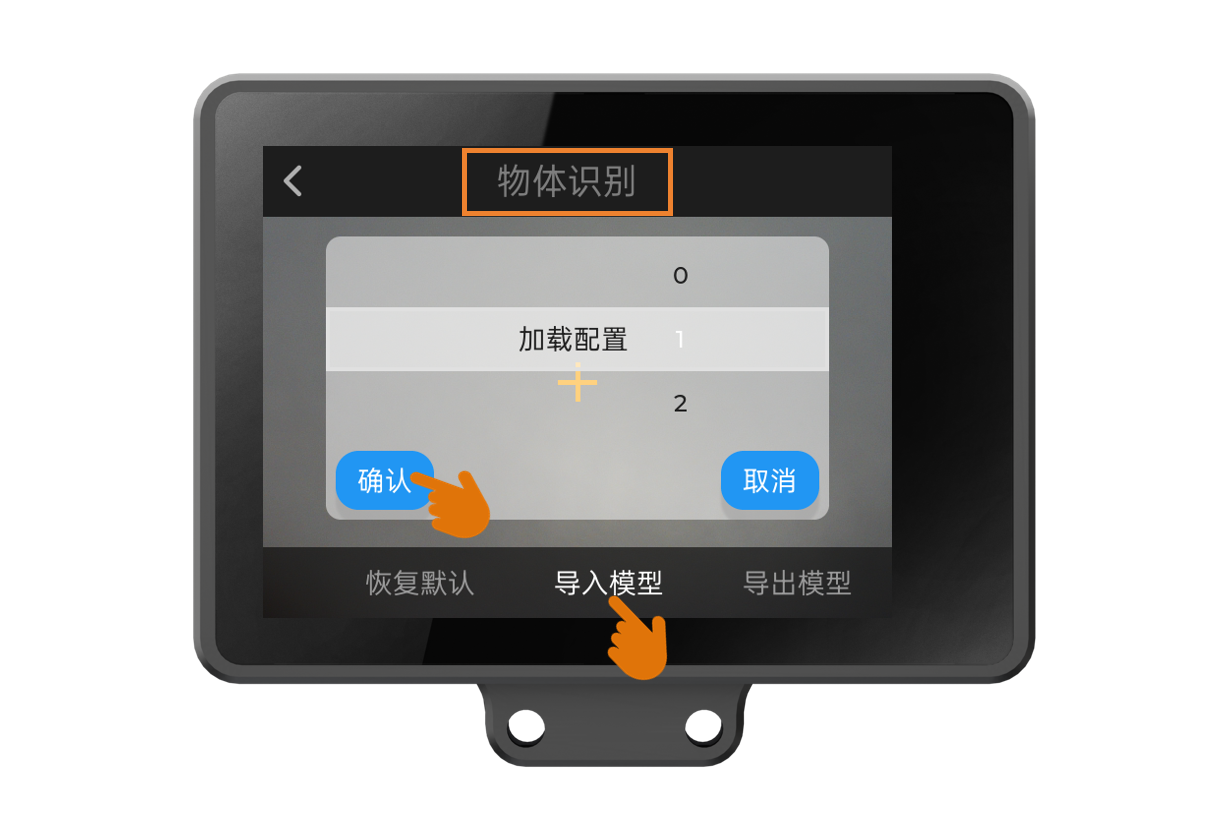
导入步骤:
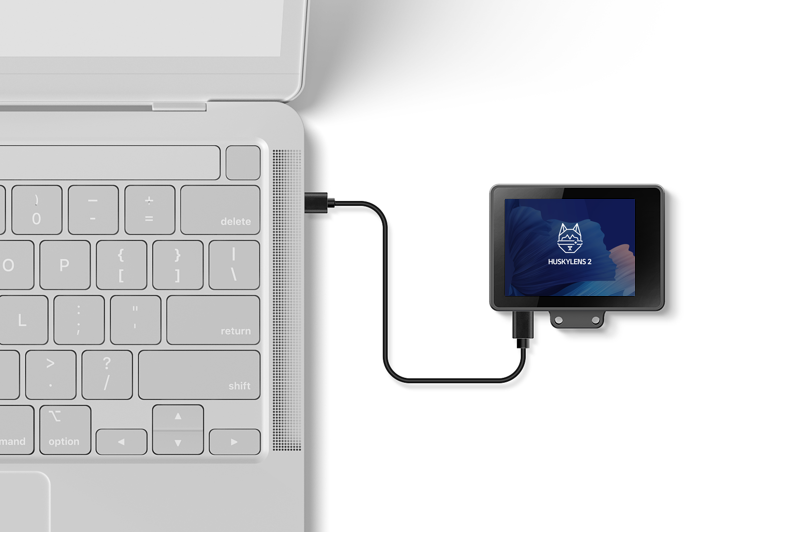
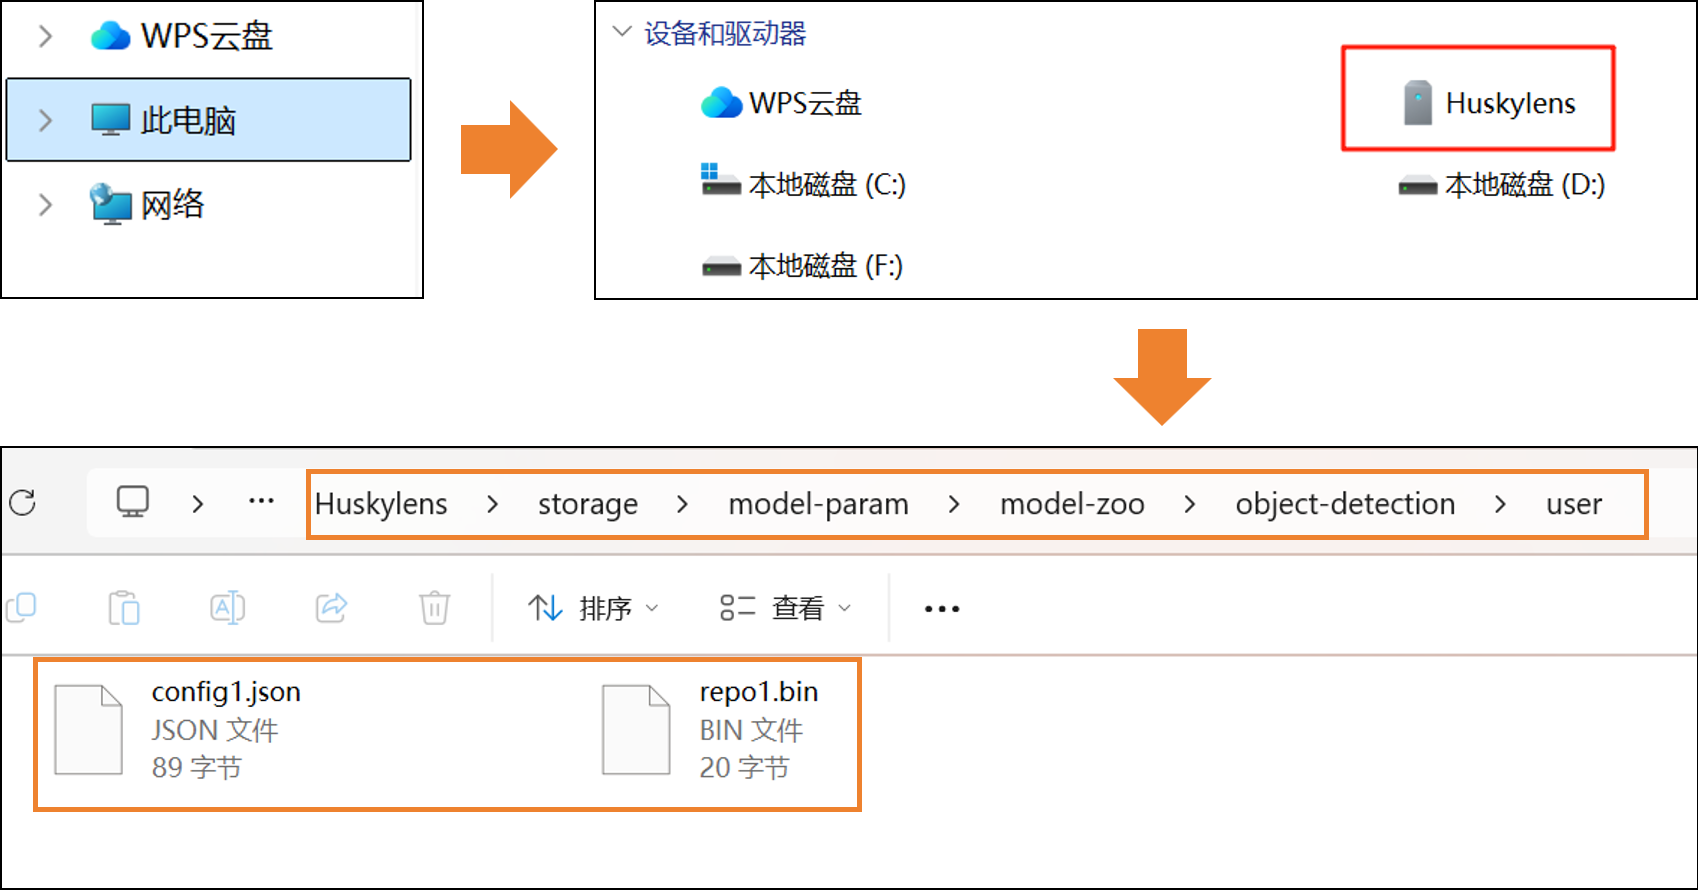
第一步,将二哈A连接电脑,把导出的2个文件复制到电脑桌面。
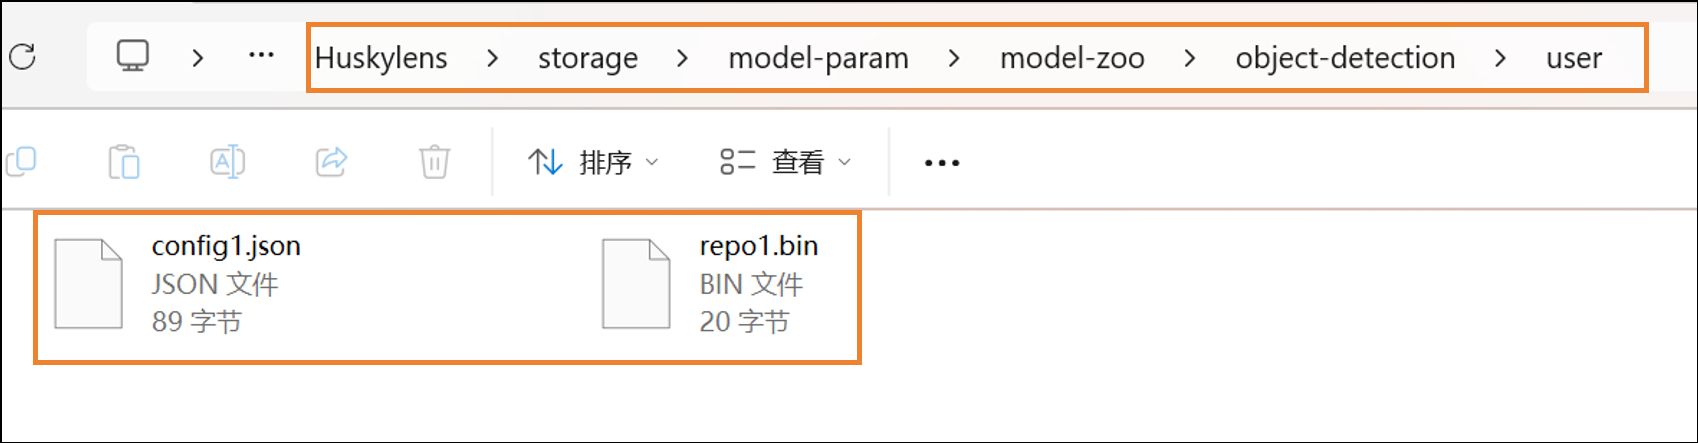
第二步,将二哈B连接电脑,把上一步的2个文件粘贴到二哈B的指定文件夹,路径如图所示。(如找不到object-detection文件夹,请先执行第三步,导入过模型,会自动创建本文件夹,随后再回到第二步。)